上海线下实训任务,在完成Prefill入图之后,为了进一步提升Prefill效率,降低首字延迟,按照导师的手册需要对Chunk算子进行融合。
导师给出的任务手册提示很简洁:
优化方法: Prefill 阶段存在大量细粒度 Chunk 算子,这些算子依赖 CPU 临时下发指令,导致 Free 耗时占比依然偏高,成为新的性能瓶颈。
参考PR:https://github.com/vllm-project/vllm-ascend/pull/11687
参考commit适配对模型侧调用逻辑进行适配:https://github.com/shaopeng-666/vllm-ascend/commit/3098432b807a98295f61336efb239e6c627cb98a#diff-e8ab291496b81b062131610fdce9b334e1b51e1560de7853e4f6bdbdef93c38a
注意:该融合策略对精度有极微的影响,表现为输出 Token 的个别数值波动,但整体语义理解能力保持完整。
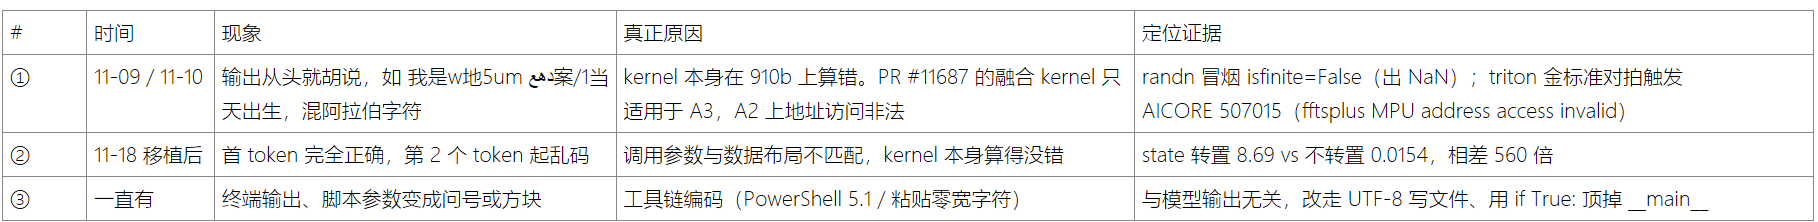
笔者一边理解PR中的操作一边借助AI工具进行辅助编码,好不容易完成了迁移然后遇到了乱码的情况:
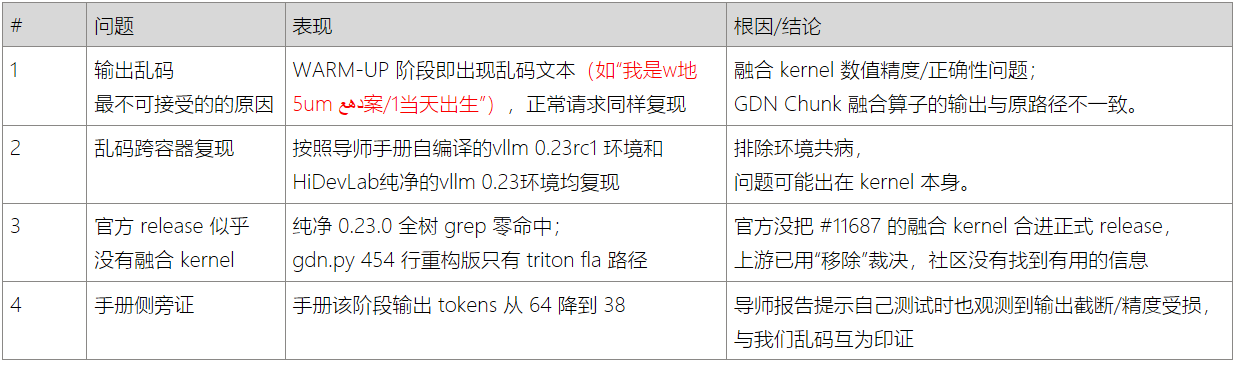
这也是实训过程中遇到的最大困难:【commit 里融合路径被 use_a3_fused_gdn_prefill() 门控】,说明PR只对 A3 生效,但实训的环境是A2,同时算子是在vllm0.25环境中编译的,实训的环境是vllm0.23。
当笔者的能力无法继续的时候,笔者召唤求命稻草ModelAgent在笔者的MD文件记录基础上开始【接管实验】,并最终成功完成迁移改造。
改动总共分为4层:
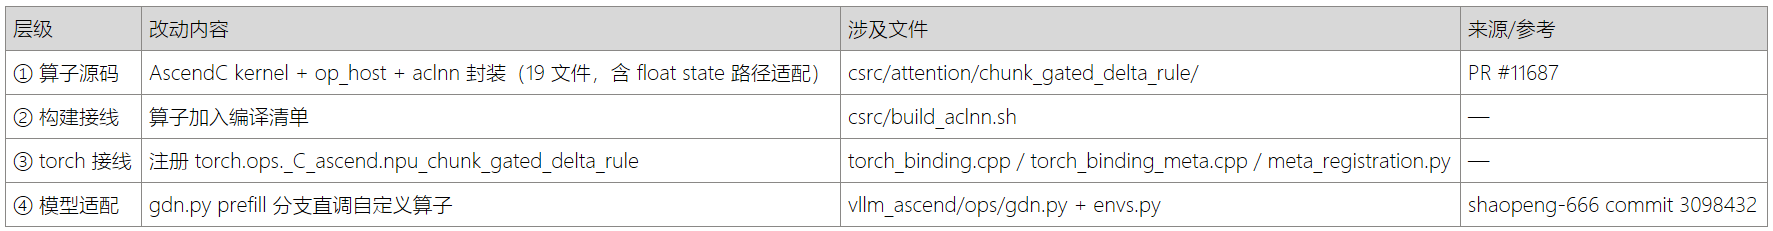
实现步骤:
1.拷入算子源码:cp -r chunk_gated_delta_rule /vllm-workspace/vllm-ascend/csrc/attention/
注意总共19 个文件;不能直接用 PR #11687 原版,它基于 v0.25.1,导师要求的环境是从vllm0.22rc升级到的vllm0.23
2.应用补丁:cd /vllm-workspace/vllm-ascend && git apply <包>/tracked_changes.patch
一共含 6 文件:build_aclnn.sh、torch_binding.cpp、torch_binding_meta.cpp、meta_registration.py、envs.py、gdn.py
3.编译 CANN 算子:bash csrc/build_aclnn.sh /vllm-workspace/vllm-ascend ascend910b
注意一定要先 source set_env.sh
产物自动安装到 vllm_ascend/_cann_ops_custom/vendors/...,运行时经 ASCEND_CUSTOM_OPP_PATH 加载
4.ModelAgent检测该路径 ninja 文件依赖正常,自动重编
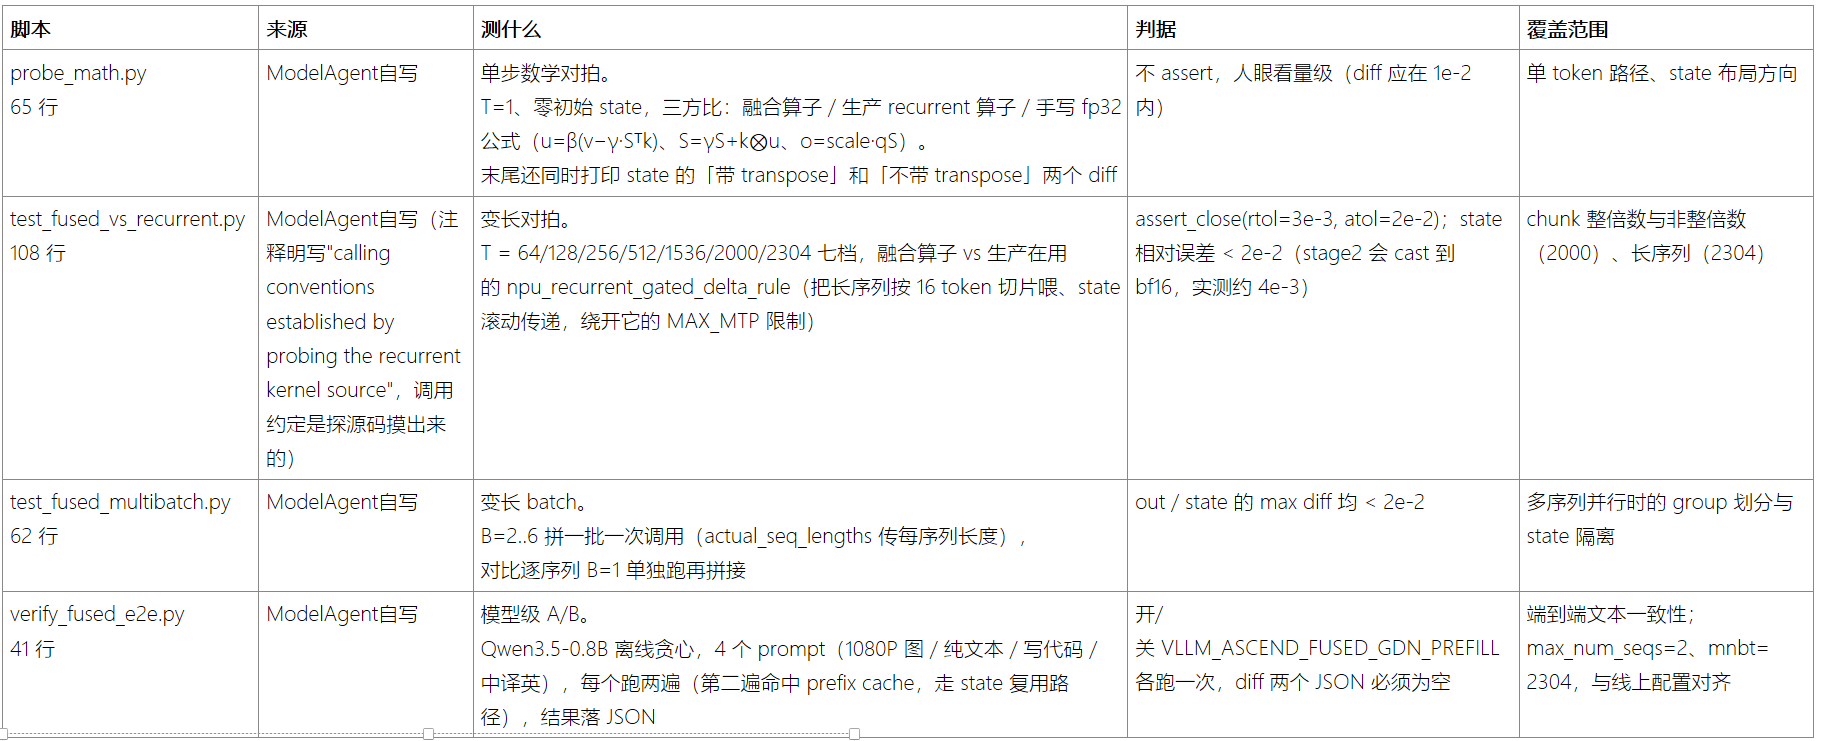
5.probe_math.py —— T=1 手写 math 对拍
test_fused_vs_recurrent.py —— T=64..2304 对比生产 recurrent 算子
test_fused_multibatch.py —— B=2..6 对比逐序列(bit-exact)
6.模型级验证:verify_fused_e2e.py <输出文件> 跑两次(一次带 VLLM_ASCEND_FUSED_GDN_PREFILL=1),对比 JSON 文本
7.A/B 性能:bench_offline.py(预热拉频 + 30 warmup 协议,同宿主负载对比)
涉及的脚本包括:
完成算子编译后,需要进行对拍验证
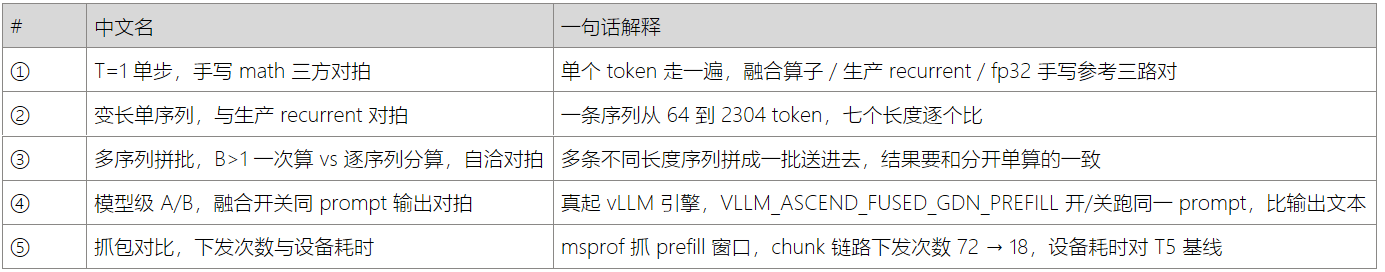
以下是算子对拍的全部记录:
① T=1 单步,手写 math 三方对拍
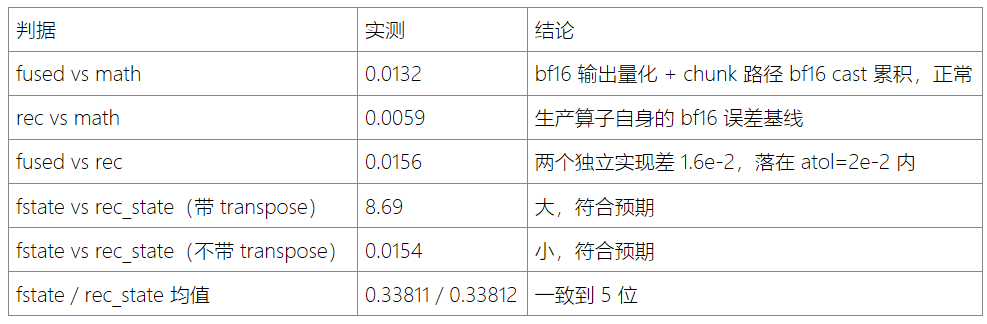
fused vs math diff: 0.013187646865844727
rec vs math diff: 0.0059282779693603516
fused vs rec diff: 0.015625
fstate: 0.3381098210811615 rec_state: 0.33812153339385986
fstate vs rec_state diff: 8.691722869873047
fstate vs rec_state diff (no transpose): 0.015401840209960938
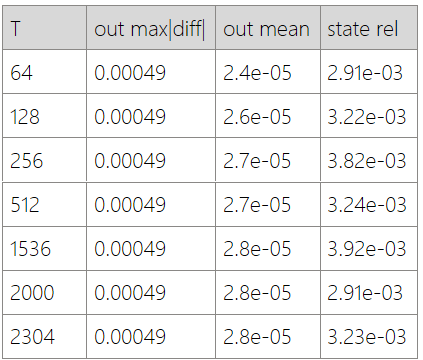
② 变长单序列,与生产 recurrent 对拍
exit=0
ALL PASS
③ 多序列拼批,B>1 一次算 vs 逐序列分算,自洽对拍
exit=0
[B=3 256/128/128] out max|diff|=0.000000 state max|diff|=0.000000
[B=3 256/128/128] PASS
[B=2 400/300] out max|diff|=0.000000 state max|diff|=0.000000
[B=2 400/300] PASS
[B=6 mixed] out max|diff|=0.000000 state max|diff|=0.000000
[B=6 mixed] PASS
[B=3 short] out max|diff|=0.000000 state max|diff|=0.000000
[B=3 short] PASS
ALL PASS
[B=6 mixed](含 63/65/1)也是 0,说明:
● actual_seq_lengths 分段后,chunk 不会跨序列边界拼接;
● 短段(T=1、T<64)的填充与 mask 处理,与 B=1 单独算完全一致;
● initial_state 按 batch 索引没错位;
● group 调度的 batch 维映射精确,因为结果逐位一致,说明每次读取的 state 槽位、每个 chunk 的偏移完全对齐,没有引入额外数值路径。
三个算子级台阶(①②③)全部收尾,证据链完整:① 证明数值和布局对,② 证明长序列不漂移,③ 证明批调度不走样。
接下来需要启动模型进行④模型级 A/B验证,融合开关同 prompt 输出对拍:
python3.12 -c "from vllm_ascend import envs; print('off =', envs.VLLM_ASCEND_FUSED_GDN_PREFILL)"
off = False
VLLM_ASCEND_FUSED_GDN_PREFILL=1 python3.12 -c "from vllm_ascend import envs; print('on =', envs.VLLM_ASCEND_FUSED_GDN_PREFILL)"
on = True
前台验证:
base1 exit=0
base2 exit=0
fused exit=0
python3.12 verify_logprob_scan.py --cmp /workspace/scan_base1.json /workspace/scan_base2.json 2>/dev/null | grep -E "^p[0-9]|pos="
p0 positions=139 flips=0 max|dlogp|=0.000000
p1 positions=129 flips=0 max|dlogp|=0.000000
python3.12 verify_logprob_scan.py --cmp /workspace/scan_base1.json /workspace/scan_fused.json 2>/dev/null | grep -E "^p[0-9]|pos="
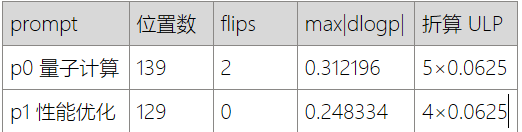
p0 positions=139 flips=2 max|dlogp|=0.312196
pos=45 gap=0.1250 dlogp=0.1344 FLIP-OK(gap<dlogp)
pos=113 gap=0.1250 dlogp=0.1262 FLIP-OK(gap<dlogp)
p1 positions=129 flips=0 max|dlogp|=0.248334
到此:
① T=1 三方对拍通过(state 布局转置 8.69 vs 0.0154,差 560 倍)
② 七种长度对拍,输出差恒为 0.00049(1 ULP),36 个 chunk 无漂移
③ 拼批自洽,全部 0(逐位)
④ 引擎跨进程确定(268 位置全零),融合路径 logprob 差 4~5 ULP、268 位置中 2 个 argmax 翻转,翻转点 gap=0.125 < dlogp=0.126~0.134,属必然翻转。
结论:数值等价,文本分叉源于贪心解码在近似平局处翻转。
最后执行⑤抓包对比,下发次数与设备耗时:
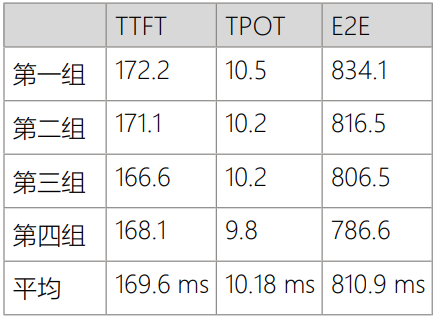
A组-未融合算子:
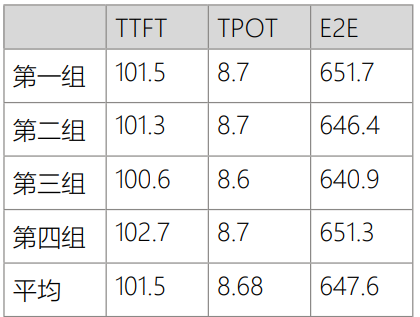
B组-融合算子:
在启动之前笔者特地做了冒烟测试,确认没有乱码以后终于服了ModelAgent(也可能就是笔者刚开始接触,水平不够)
=====================
通过对抓取并下载到本地的信息进行AI辅助分析可知:
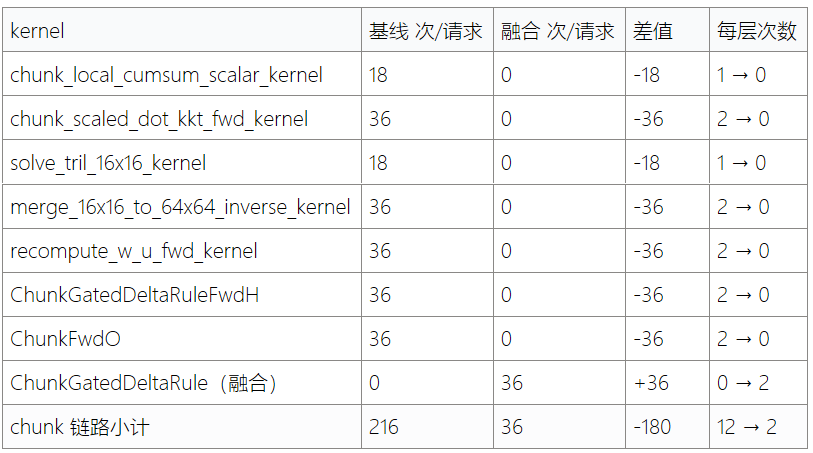
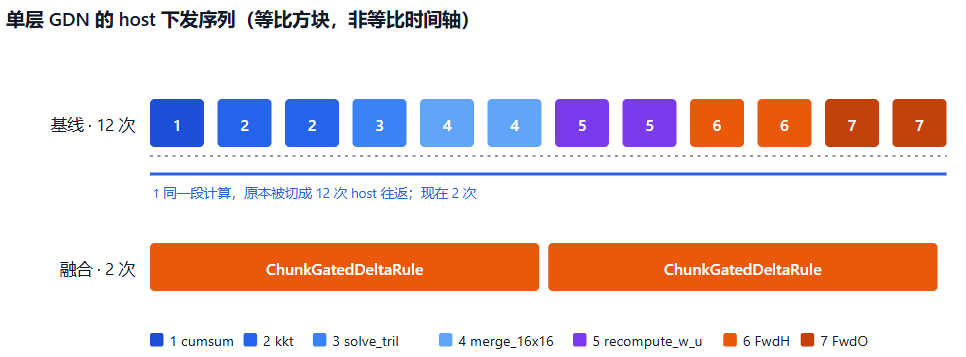
① 下发次数:单层从7下降到2,每请求从126下降到36(−71.4%)
② Host CPU 时间:从4.383下降到 0.536 ms/请求(−87.8%)
单层从 212.8 μs 降到 29.7 μs,主要来源是workspace 查询消失;
基线每次 aclnn 调用要重算一次 workspace(49.5 μs / 62.1 μs 各 1800 次),融合后只剩 10.4 μs。
③ 下发间隔:从“密集下发”变成“长间隔单次”
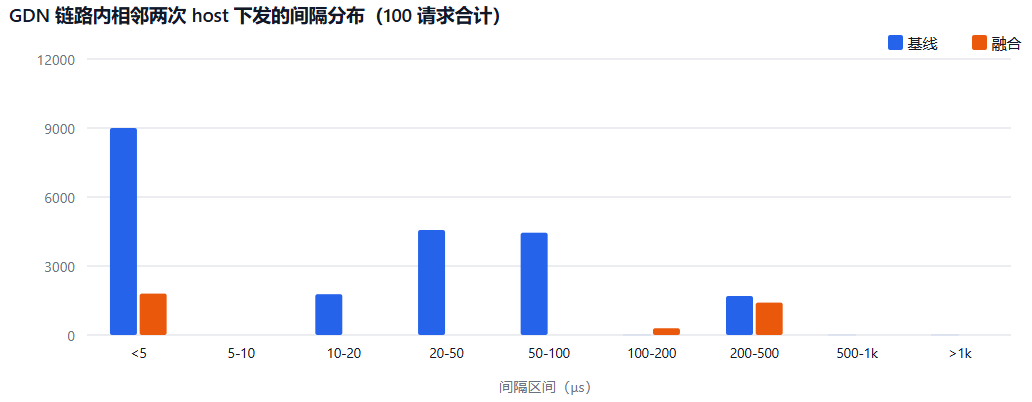
基线呈双峰分布:同层内 kkt→FwdH 连续下发(<5 μs),层间 100~200 μs,共 12,500 个间隔;
融合后只剩 3,500 个,全部集中在 200~500 μs;CPU 不再被切成 7 段去追,从“下发密度”层面得到改善。
=======================
虽然笔者手搓失败,但是借助ModelAgent还是完成了导师的作业要求:
总结而言:
1.链路合并成立。
基线每层 12 次下发(cumsum×1、kkt×2、solve×1、merge×2、recompute×2、 FwdH×2、FwdO×2),融合后 2 次(ChunkGatedDeltaRule×2);18 层合计 216 → 36 次/请求,降幅 83.3%。
2.链路 host 时间由 4.38 ms/请求 降到 0.536 ms/请求 (-87.8%),单层从 243.5 μs 降到 29.8 μs, 复算比 8.2×;这是"CPU 侧临时拼装下发"这一瓶颈被直接削掉的量化证据。
3.下发节奏从"碎"变"整"。链路内间隔中位数 19.0 μs → <1 μs (同层两次下发背靠背),间隔总数 21500 → 3500; >100 μs 的层间大间隔占比从 8.0% 涨到 48.6%,这说明印证"层内不再有 11 次往返、只剩 1 次"。
4.整请求下发量降幅有限。
KERNEL+MEMCPY 总数 5064 → 4560 次/请求 (-504,-10.0%)。
因为 decode 阶段的 MEMCPY_ASYNC(2248 次/请求)与 KERNEL_AIVEC 占绝对多数,chunk 链路只是其中一段。
5.唯一反向项 Sub +18(融合算子内部多做一次减法)。
6.端到端延迟下降。
TTFT 169.6 → 101.5 ms(−40.2%),E2E 810.9 → 647.6 ms(−20.1%)。 但本次 profiling 只能归因约 9.5 ms,不写进收益。
最后笔者将ModelAgent的操作和自己手搓的操作记录导入AI Agent,让AI尝试找出出现乱码的原因,不得不说笔者还需要继续学习~
本文由 奶莉小跟班 原创,首发于华为昇腾社区,哦对了,我就是奶莉小跟班~~~~