昇腾上海线下实训LAB3:
昇腾A2单卡环境Qwen3.5-0.8B@vLLM-Ascend多模态推理性能调优
实验要求:
针对昇腾 A2 单卡环境,在单并发、1080P(1920×1080)高清图像输入的典型端侧视觉理解场景中,
基于 vLLM 推理框架,围绕算子实现、计算图结构、内存调度及多模态预处理链路展开系统性性能调优,
优化首字响应延迟(TTFT)和逐 Token 生成速度(TPOT)指标。
单请求输入1080P图片,输出tokens数64,达到:
1.E2E 总耗时要求<0.6s
2.TTFT要求<250ms
3.TPOT< 10ms
实验环境:
HiDevLab容器:昇腾A2,CANN_9.0.0 Release, OpenEuler24.03,1NPU 32G内存 32核CPU 300G存储
============
本帖只要分享在实现Prefill入图优化过程中,自己的学习心得和验证过程。
vllm0.23的cudagraph_mode支持三种模式:
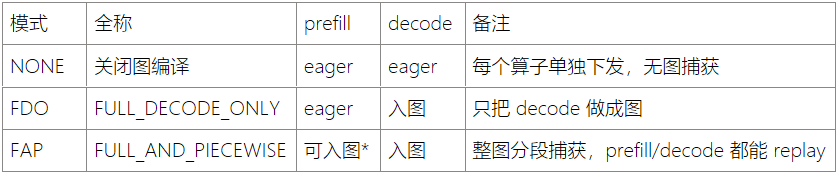
NONE:每生成一个 token,host(CPU)要把几百个算子逐个下发到 NPU,host 调度开销远大于 NPU 计算本身。
实验实测:TPOT 72ms(对比入图后的TPOT 8~11ms可得出结论:Prefill入图和Decode入图都是本次优化的核心)
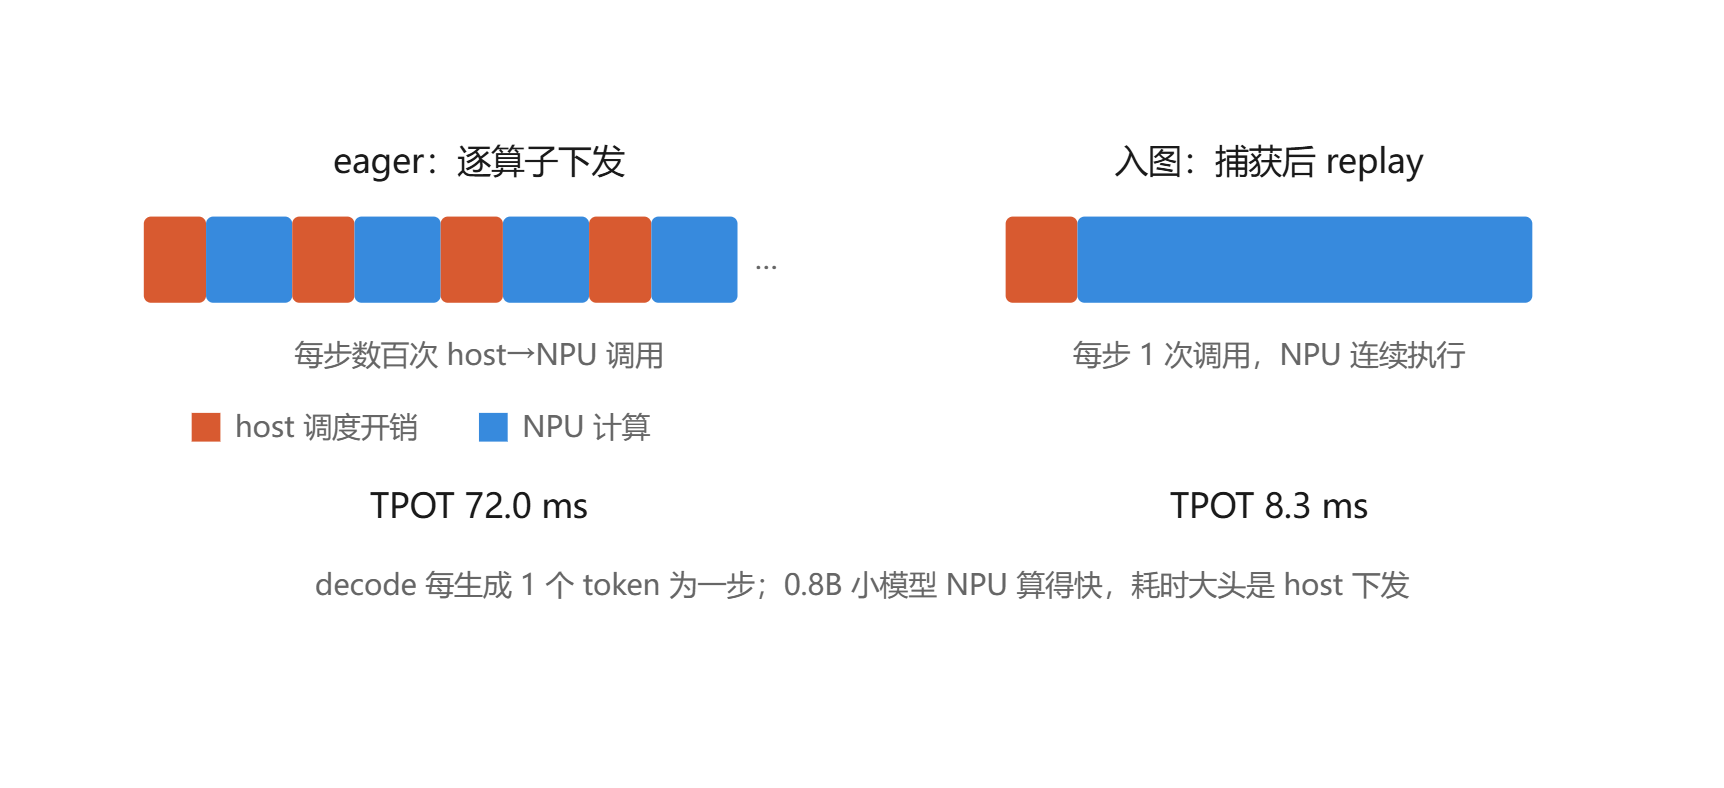
FDO:decode 每 token 走的计算形状完全固定(batch、token 数都一样),是图捕获的完美场景,replay 消掉全部 host 下发开销 → TPOT 72→11ms。但 prefill 形状随输入 token 数变化(实验要求 2055 tokens),传统整图捕获对不上,所以 prefill 保持 eager;
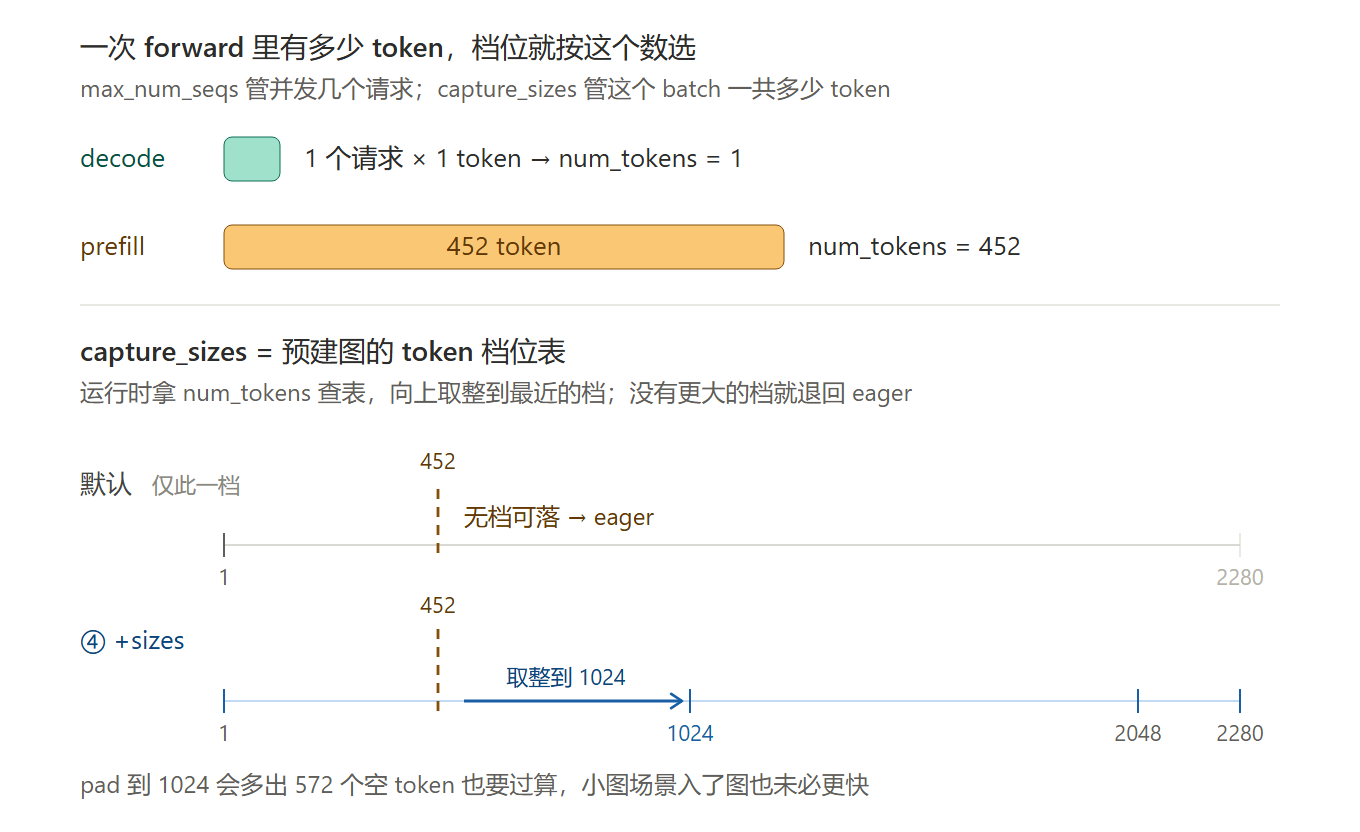
FAP:把模型在注意力算子处切开,前后非注意力部分分别捕获成图(piecewise=分段),attention 现算。好处是 prefill 也能吃到图收益,但要求前提是 cudagraph_capture_sizes 里要有覆盖 prefill token 数的档位。
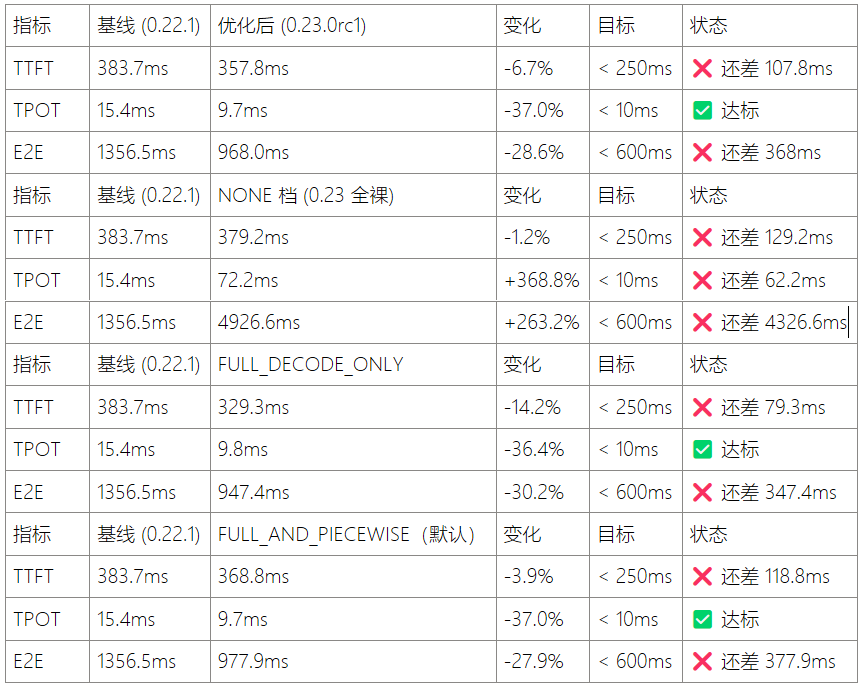
由实验结果可知,仅仅更改cudagraph_mode无法从根本上提升性能,但Decode入图可以提升10%的性能,将TTFT压缩到330ms上下。
接下来进一步固化Prefill入图:
根据导师手册提示,组 A:固化配置
VLLM_ENABLE_V1_MULTIPROCESSING=0 PROF_DIR=/workspace/prof_A \
CC_JSON='{"cudagraph_mode": "FULL_AND_PIECEWISE", "cudagraph_capture_sizes":[1,2,3,4,8,16,24,32,64,128,144,152,168,184,200,256,1024,2048,2279,2280,3072]}' \
接下来是笔者理解导师手册中这些数字的含义:
●
机制约束(多或者少都不合适)
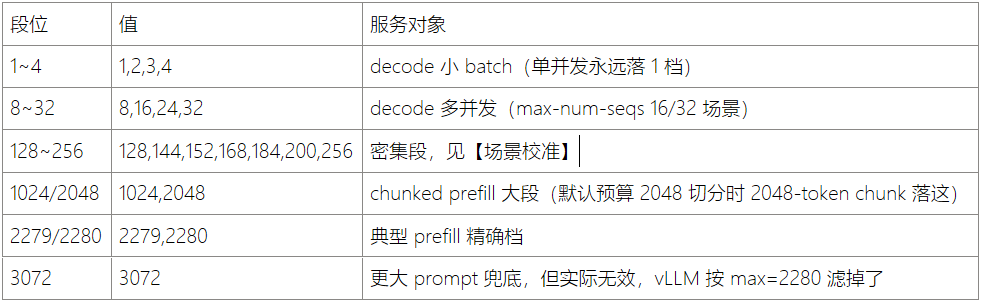
每个档位 = 捕获一张独立的图,每张图占一份独立显存(激活 buffer 按该档位大小预留)。档位越多显存吃得越多,所以列表长度天然受限(20 个左右已是合理上限)。同时因为运行时是“向上取整 pad 到最近档”,档位太稀 = pad 冗余大,太密 = 显存爆炸——列表本质上是在这两者间找平衡。
●
结构分层
●
场景校准
128~256 每 8~16 递增的密集段,唯独2279/2280 这两个精确值,不是公式算出来的,大概率是按照导师实测负载的 num_tokens 分布校准的:
decode 多并发混跑时,每步 num_tokens = batch 大小(或 batch+chunked prefill 残段),会出现各种非 2 幂的值(比如 17 个并发就是 17,pad 到 32 冗余 47%);密集段就是为了让常见 batch 值都能贴近落档;本次实验的prompt实测长度是2055,最终落在2279档位。
所以其实20个档位中,2279、2280、3072是可以自定义的,在其他场景中可以通过serve 日志或 bench 中的num_tokens分布进行调整。
在本实验中,"cudagraph_capture_sizes":[1,2,3,4,8,16,24,32,64,128,144,152,168,184,200,256,1024,2048,2056,2279,2280]}' 是最优解。
实测验证:
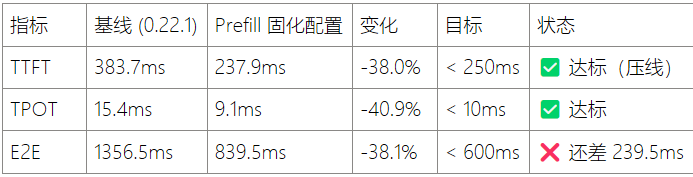
但从实验数据来看,TTFT降低了接近40%,已经压线达标导师要求的数字,但E2E虽然同样降低了40%,但依旧没有达标。
当笔者的能力无法进一步优化的时候,ModelAgent开始介入。
因为组 B:固化 + 2304 预算
首先来看一下vllm0.23主仓的默认定义MNBT值:
grep -rn "DEFAULT_MAX_NUM_BATCHED_TOKENS" /vllm-workspace/vllm/vllm/ --include="*.py"
/vllm-workspace/vllm/vllm/config/scheduler.py:42: DEFAULT_MAX_NUM_BATCHED_TOKENS: ClassVar[int] = 2048
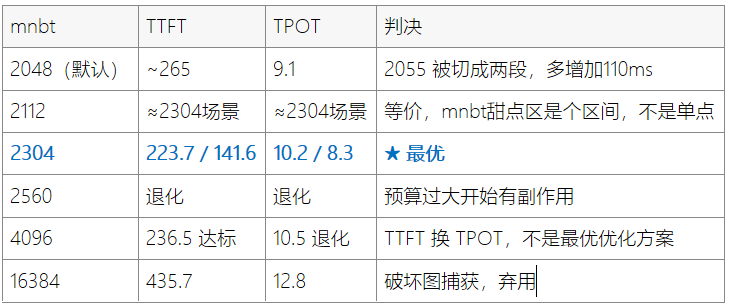
由此可见,本次实验中因为1080p图像的prompt输入是2055tokens超过2048的默认值,因此被切成 2048 + 7 两段,跑两次 prefill 迭代。
第二段只有 7 个 token 却要付一整套固定开销(调度、block table 提交、KV 写入、图调度)。
为了确保MNBT值的设定能满足2055tokens一次算完,MNBT就需要从默认的2048修改成>=2055。
为了确定这个2048+x的这个x,ModelAgent开始根据经验进行步长选取和测试:
实测验证:
VLLM_ENABLE_V1_MULTIPROCESSING=0 PROF_DIR=/workspace/prof_B \
MNBT=2304 \
CC_JSON='{"cudagraph_mode": "FULL_AND_PIECEWISE", "cudagraph_capture_sizes":[1,2,3,4,8,16,24,32,64,128,144,152,168,184,200,256,1024,2048,2279,2280,3072]}' \
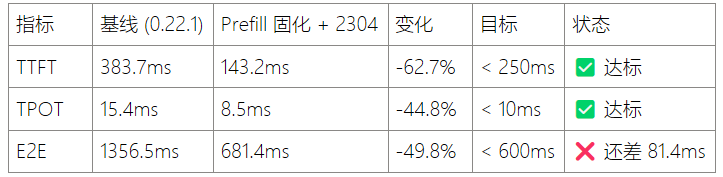
可以看到TTFT减少110ms后,指标已经远低于导师要求的250ms,
因为E2E ≈ TTFT + (输出 tokens - 1) × TPOT = TTFT + 63 × TPOT,在更改MNBT后,E2E基本稳定在143+63x8.5≈ 680ms,
根据导师的要求,E2E还有80ms左右的优化空间。
总结来看,入图确保一次读完,MNBT确保一次处理完,两者共同作用有效提升了TTFT和E2E性能指标。
笔者为了深刻理解,针对本次优化进行了5轮验证:
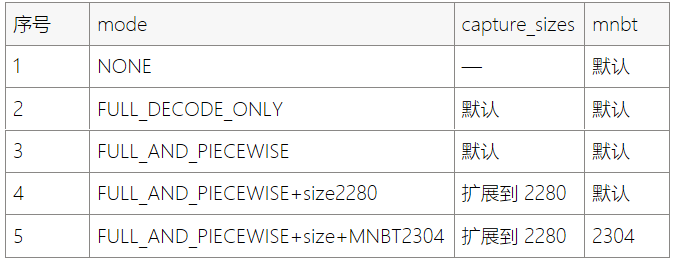
无论测试控制变量,仅更改必要的选项:
① NONE
compilation_config={"cudagraph_mode": "NONE"}
② FDO
compilation_config={"cudagraph_mode": "FULL_DECODE_ONLY"}
③ FAP
compilation_config={"cudagraph_mode": "FULL_AND_PIECEWISE"}
④ FAP+sizes
compilation_config={"cudagraph_mode": "FULL_AND_PIECEWISE",
"cudagraph_capture_sizes":[1,2,3,4,8,16,24,32,64,128,144,152,168,184,200,256,1024,2048,2279,2280]}
⑤ = ④ + MNBT2304
compilation_config={"cudagraph_mode": "FULL_AND_PIECEWISE",
"cudagraph_capture_sizes":[1,2,3,4,8,16,24,32,64,128,144,152,168,184,200,256,1024,2048,2279,2280]},
max_num_batched_tokens=2304
每一组均均预热1轮,测试4轮取平均值:
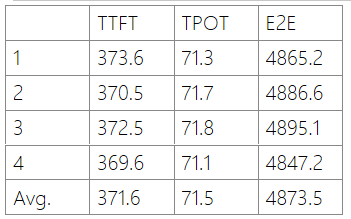
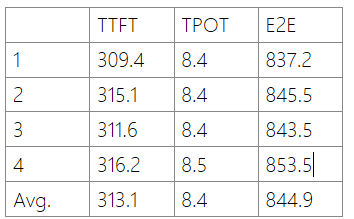
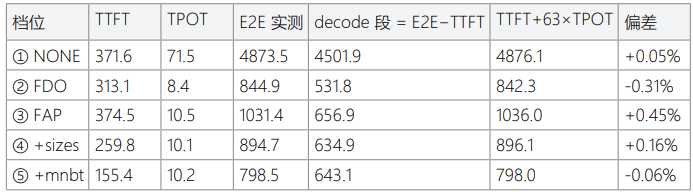
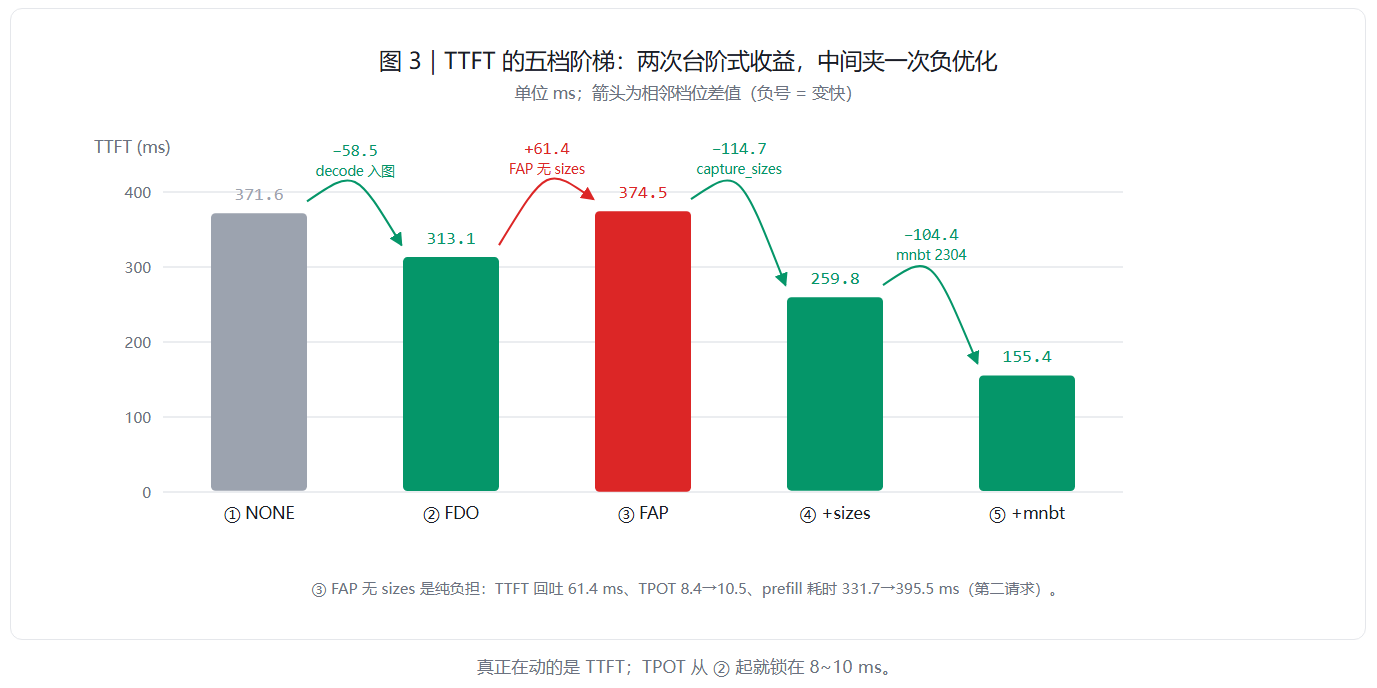
单一从数据上看,符合decode 入图、prefill eager预期,而且 TTFT 313.1 相对 ①场景的371.6 还低了 58ms,这说明 bench 有并发,decode 加速排空排队也压低了 TTFT。
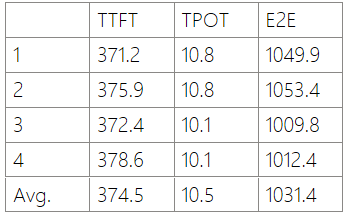
不难得出,FAP比FDO在性能上是退化的;需要进一步分析两种场景下既然Decode均入图,但为什么会有接近2ms的性能回退。
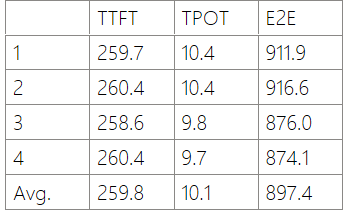
从数据上看,TTFT收益明显,但TPOT的收益不高,似乎与FDO场景的“decode 加速排空排队也压低了 TTFT”有出入。
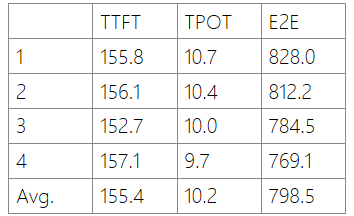
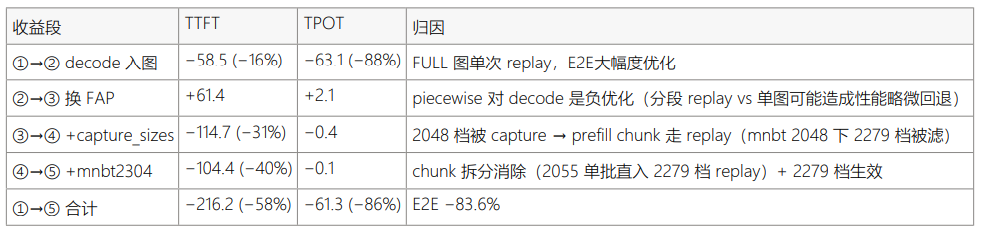
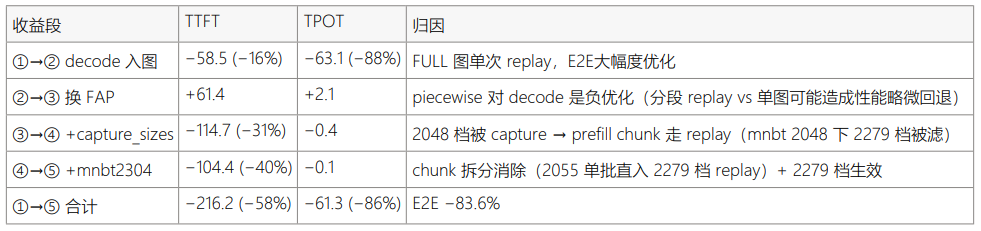
总结全部5组实验数据:

根据实验数据初步判断原因如下:
=====================
抓包分析验证猜测:
注:抓包环境tokens长度从2055变成2060,TOKENS也从64缩短到8,但不影响总体结论。
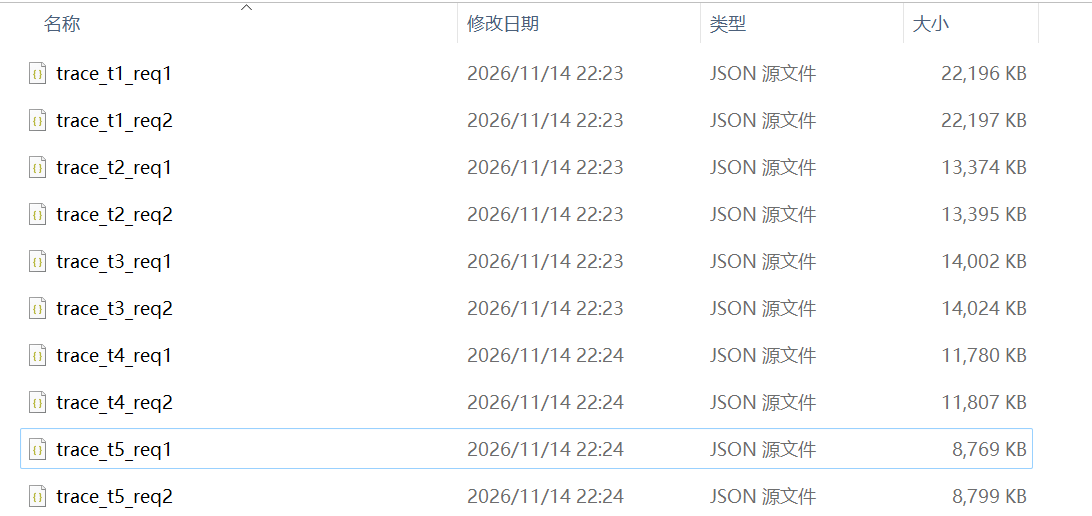
文件大小22M → 14M → 14M → 12M → 8.6M,逐档下降,这也反映从T1到T5的优化方案,将host 侧事件密度从 eager 降到 graph replay 。
从Decode性能上来看:
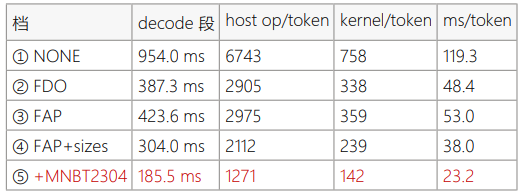
之前五轮结果测试如下:
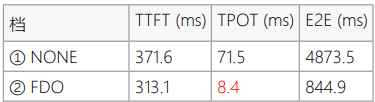
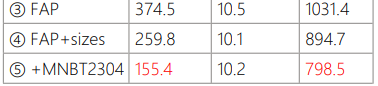
E2E ≈ TTFT + 63 × TPOT(输出 64 token,首 token 已在 TTFT 内)
忽略掉场景① 的Decode不入图,E2E性能的优化更多是TTFT的优化;其他4组63xTPOT除了② 组另类一点外,③ ④ ⑤基本保持在650ms上下。
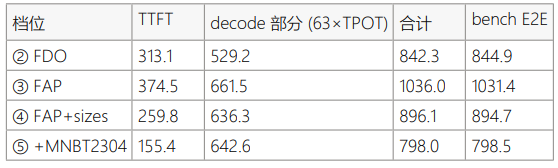
②组之所以另类的快,是因为②组是FULL整图,③ ④组是piecewise切段图,多付出了2ms左右的端间调度;④ ⑤组的Decode图相同,段间调度付出也一样,因此徘徊在10ms附近。
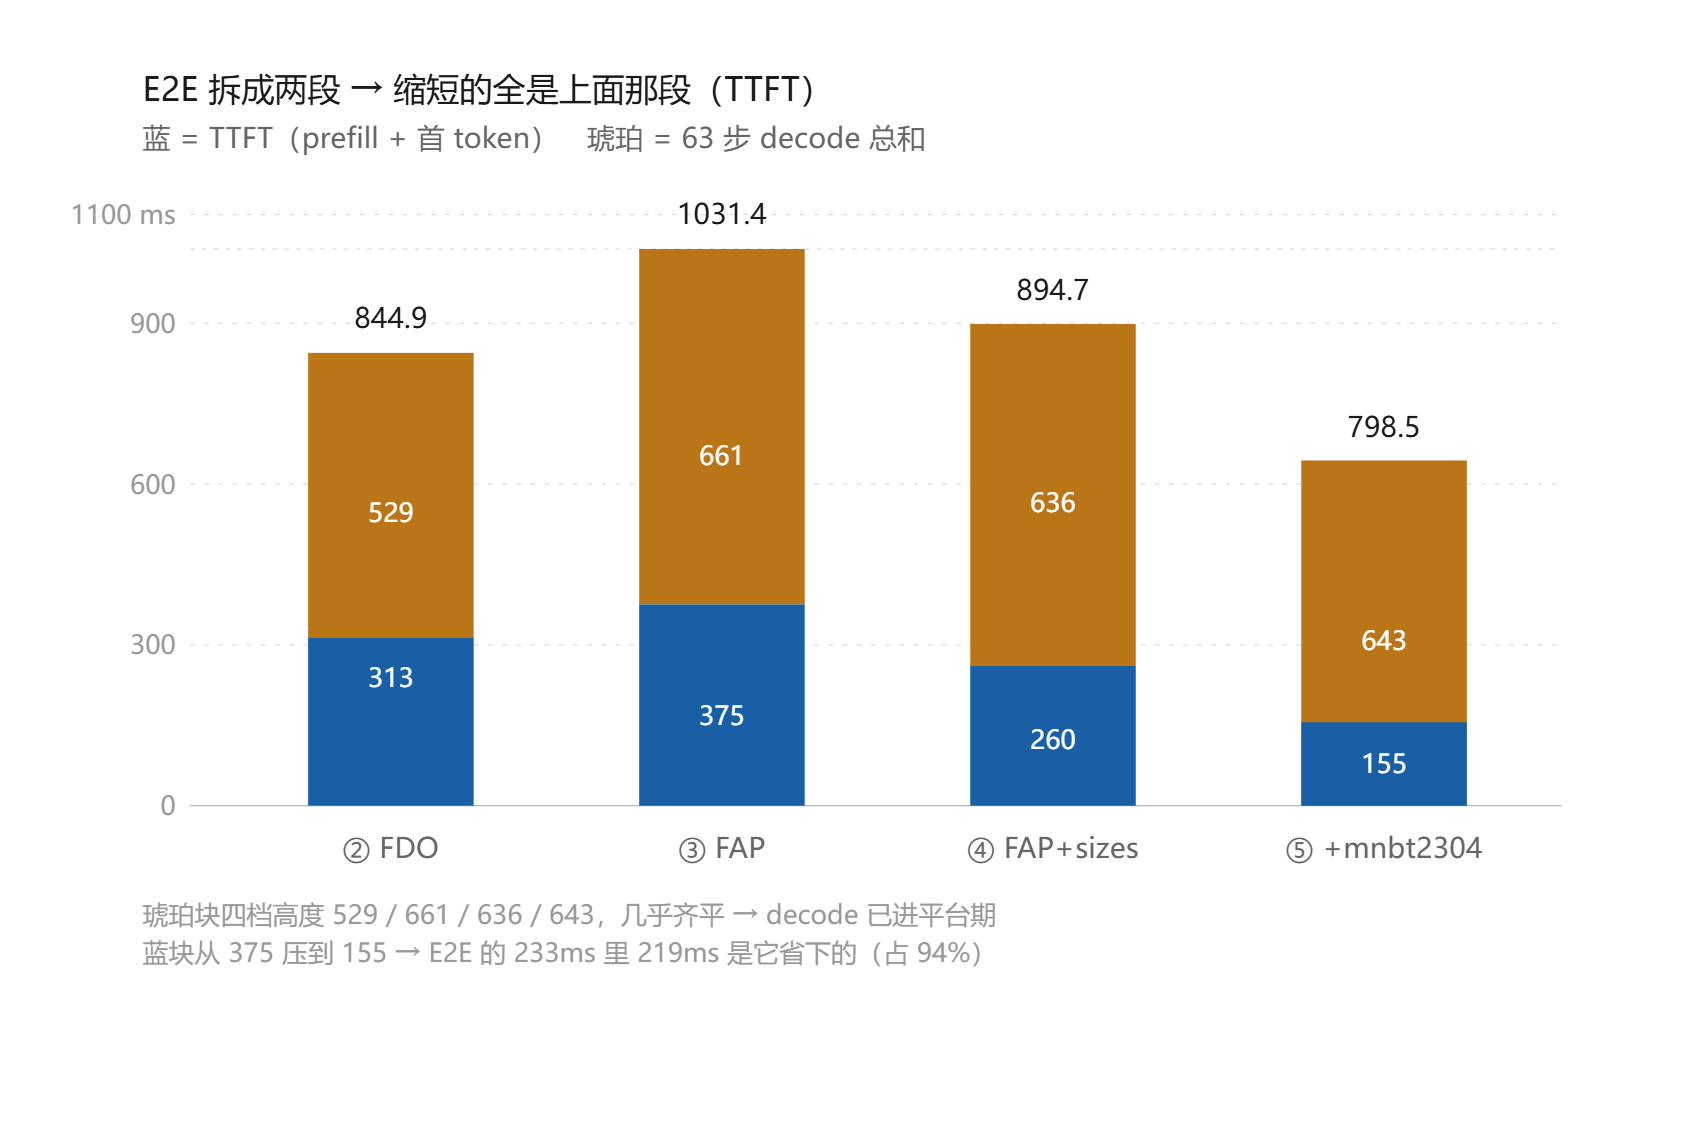
回过头来再看猜测,还有prefill阶段的性能提升没有完全验证(第一次实验的脚本无法对Prefill入图进行有效的验证)
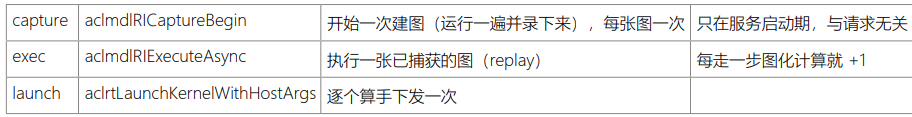
脚本记录三个操作:
实际抓包的记录情况如下:
################ t1 ################
CHECK capture=0 exec=0 launch=12130
################ t2 ################
CHECK capture=1 exec=14 launch=7011
################ t3 ################
CHECK capture=26 exec=14 launch=7927
################ t4 ################
CHECK capture=451 exec=114 launch=20431
################ t5 ################
CHECK capture=501 exec=64 launch=21030
对抓包数据进行分析记录:
1图捕获capture和重放replay符合参数定义
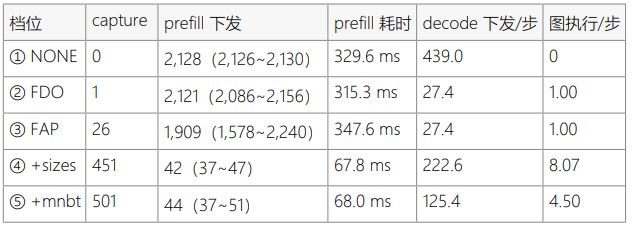
① ② 档位本身不对Prefill入图,因此均有2100+数量级的CPU到NPU下发,所以prefill耗时很多,TTFT均在300ms以上;
④ ⑤ 档位Prefill入图,因此CPU到NPU的prefill下发降低了约98%,Prefill耗时降低到了65-70ns数量级,最直观的体现就是TTFT下降了110ms以上。
如果单看②和③,在本实验样本中可能会得出FAP对FDO是负优化的结论,在初看到实验数据以及抓包数据的时候,笔者也是这样想的,但在分析了测试样本后,笔者猜测原因是2055/2060tokens超出了默认的2048限制,系统认为没有档位可以匹配,直接退回到eager模式。因为④档位相对于③只定义了cudagraph_capture_sizes,但④的确通过Prefill入图大幅度提升了性能。
笔者上传了一张小图进行测试验证:
测试结果有点出乎笔者意料:
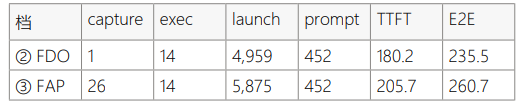
因为测试脚本设定max_tokens=8, 首 token 出在 prefill,后面 7 步是 decode。
2 个请求 × 7 步 = 14 次 replay,全部对应 decode,没有一次prefill捕获图的replay。
如果③场景的piecewise 图被 prefill 使用,就必然产生 replay;现在 replay 数量正好等于 decode 步数,没有余量,只能证明默认FAP通常不会实现Prefill入图。
通过日志确认:
'cudagraph_capture_sizes': [1]
'max_cudagraph_capture_size': 1
Capturing CUDA graphs (mixed prefill-decode, PIECEWISE): 1/1
Capturing CUDA graphs (decode, FULL): 1/1
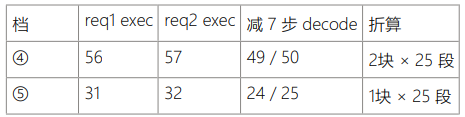
分段图的拆分由 splitting_ops 里的 vllm::unified_attention_with_output 完成,每层切一刀,Qwen3.5-0.8B 有 24 层,所以 1 个档位会被切成 25 段,再加上 1 张 FULL decode 图,合计 26 张。
笔者设置SIZES = [1, 2, 3, 4, 8, 16, 24, 32, 64, 128,144, 152, 168, 184, 200, 256, 1024, 2048, 2279, 2280],合计20个档位。
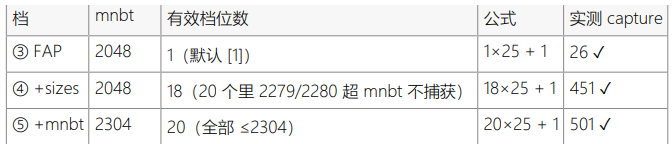
在④ ⑤两个场景中,因为笔者设置了size,因此会根据size定义的档位进行切段,实现prefill入图,但是在③的场景中,因为没有定义size,所以 max_cudagraph_capture_size is set to min(max_num_seqs*2, ...)
# compilation.py:695
If not specified, max_cudagraph_capture_size is set to min(max_num_seqs*2, ...)
同时虽然④ ⑤两个场景都实现了Prefill入图,但切分的情况还是有差异的。
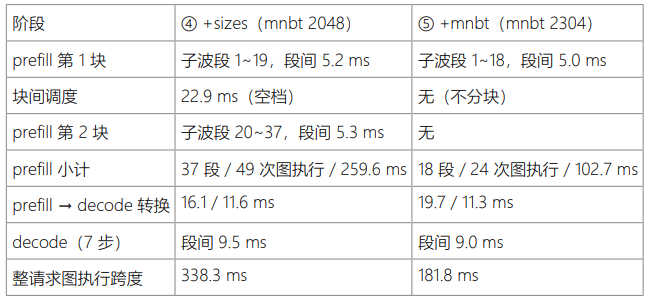
以2060那轮实验为例,⑤场景中,因为2060<2079<mnbt,因此Prefill一次入图;④场景中,2060被切分成2048+12,其中2048匹配到档位,入图,12向上取整到16档位,入图。
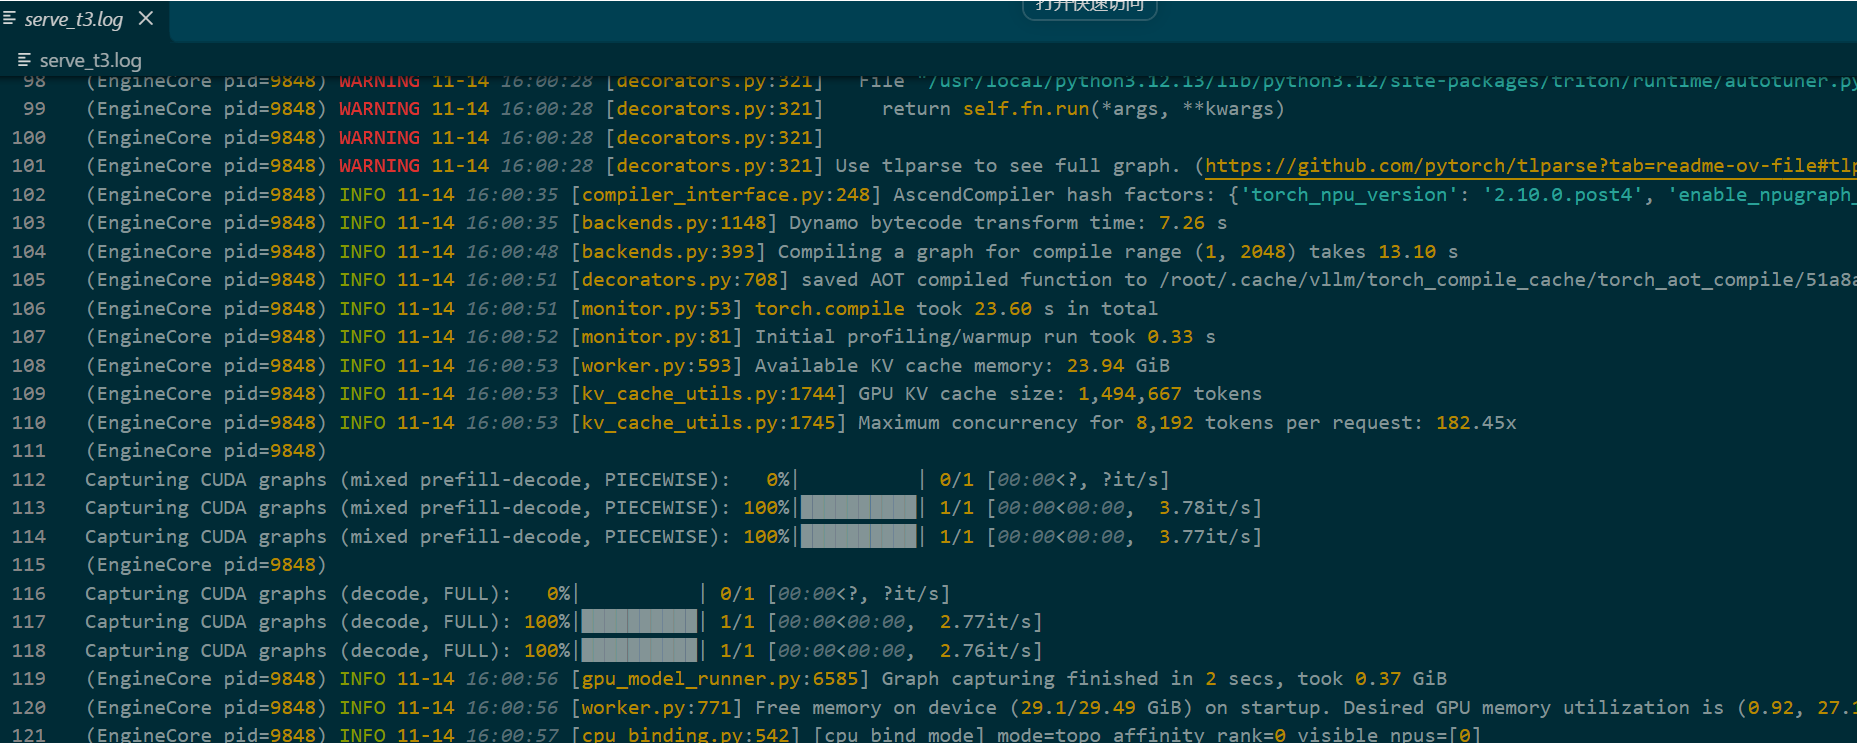
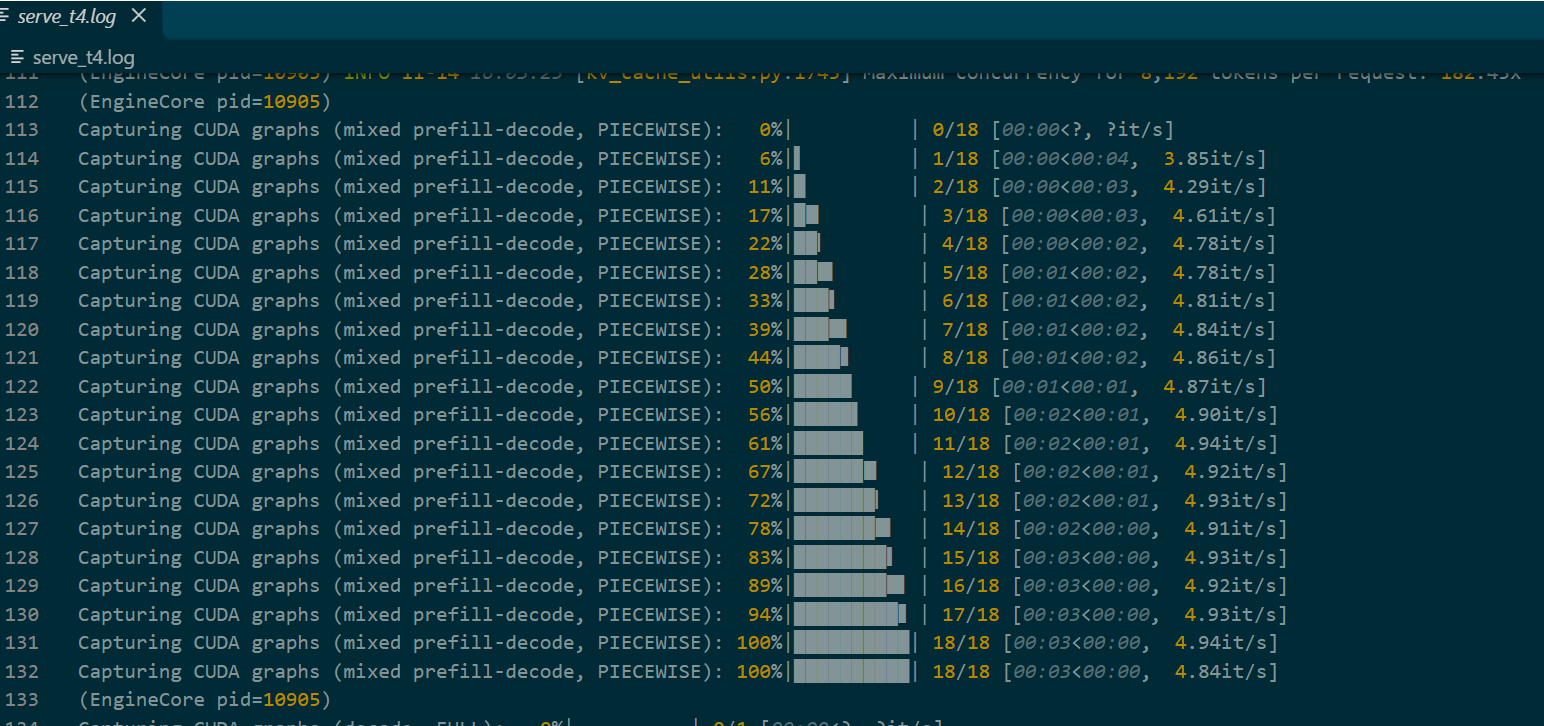
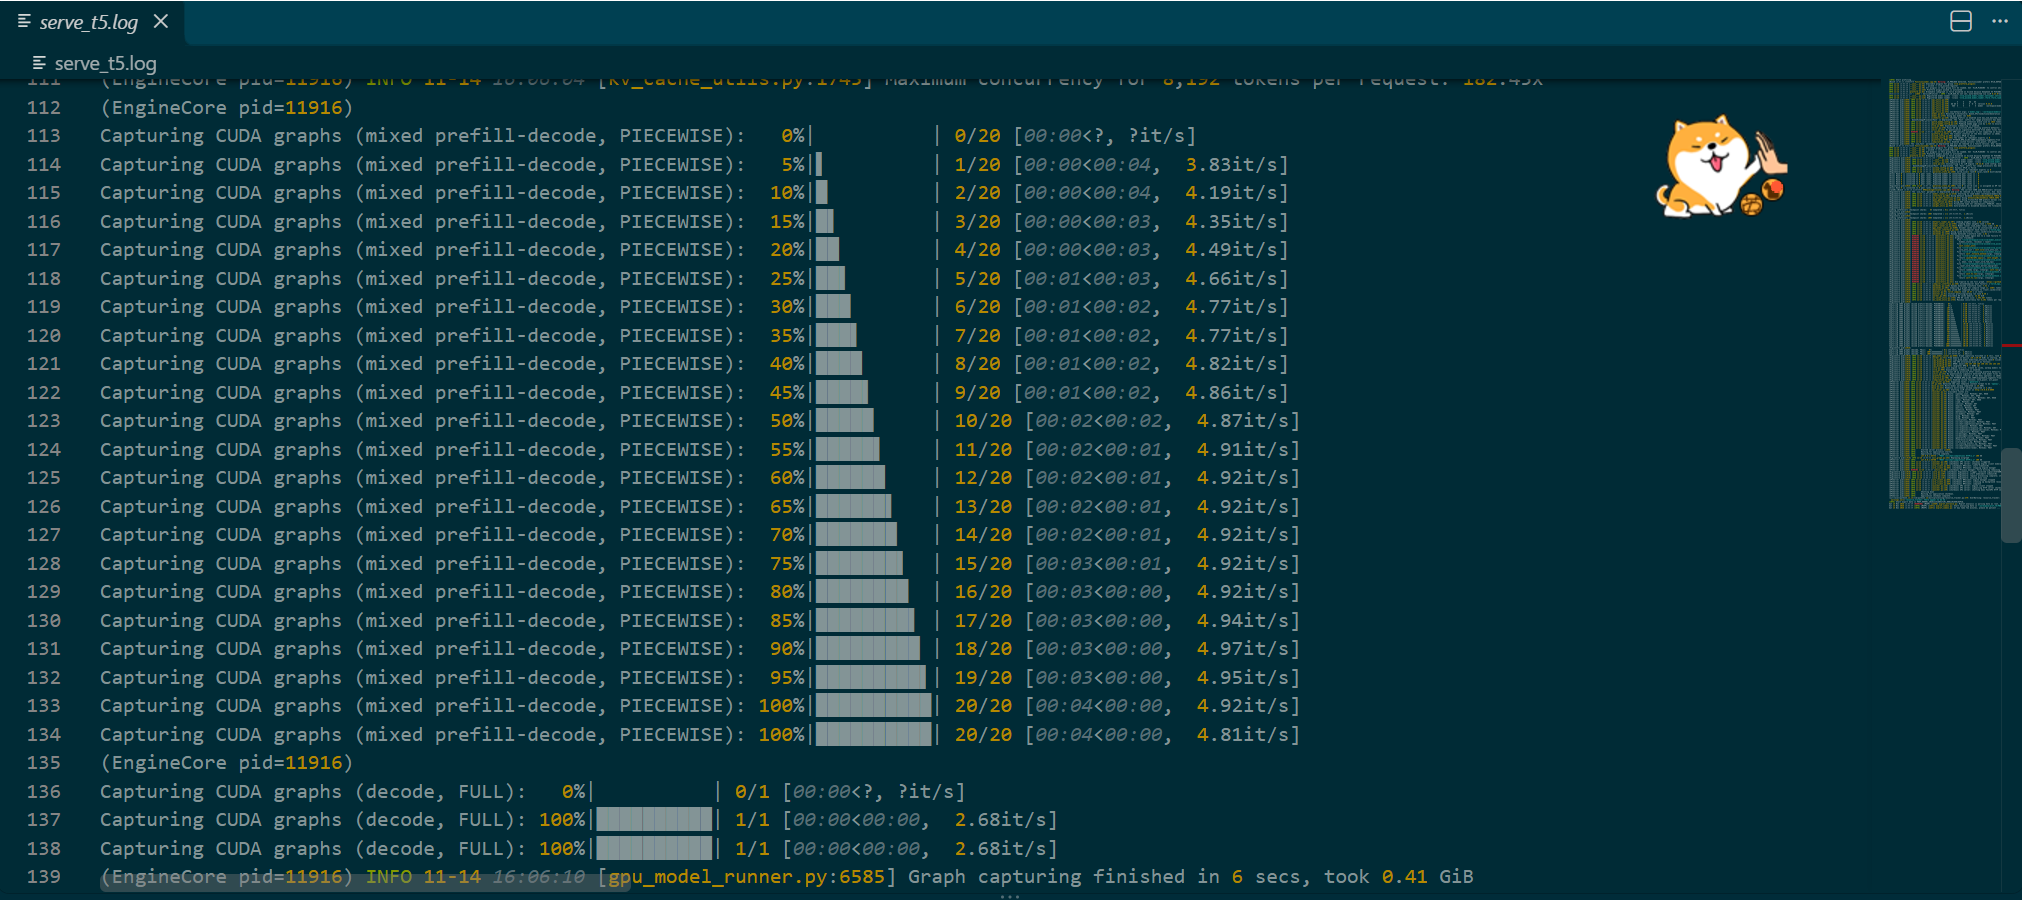
此外,既然④ ⑤两个场景都实现了Prefill入图,为何TTFT还会相差100ms以上?
通过日志分析:
虽然④和⑤都实现了Prefill入图,但是多切1块会多出的25段,段与段之间大概有5ms左右的空隙,NPU处理执行大概0.5ms左右,所以每一段时间有4.5ms左右的空隙是空等,25*4.5=112.5ms,同时块与快之间大概还有20ms左右的间隔,在Decode耗时几乎相同的情况下,④比⑤平白多出了132.5ms左右的消耗,符合338.3-181.8=156.5ms
这里笔者再次出现了一个疑问,如果③场景没有max_num_seqs 1 ,默认的FAP能否有机会实现入图?
笔者用导入的sample.jpg再次进行了验证。
按照之前python文件的定义
# compilation.py:695
If not specified, max_cudagraph_capture_size is set to min(max_num_seqs*2, ...)
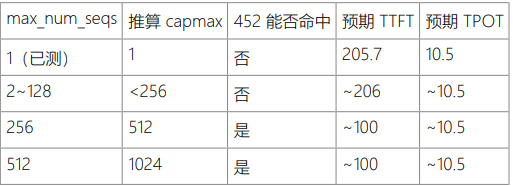
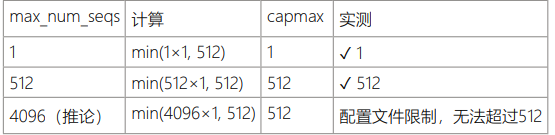
为了快速验证,笔者先对512配置进行了验证,结果和预料的还是出现了偏差:
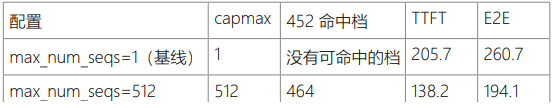
这说明capmax并不是max_num_seqs*2,肯定有vllm-ascend配置文件覆盖了vllm的配置:
vllm_ascend/platform.py:207 getdefault_max_cudagraph_capture_size()
vllm_ascend/platform.py:259 default_max_cg_capture_size = cls._get_default_max_cudagraph_capture_size(vllm_config)
vllm_ascend/platform.py:261 compilation_config.max_cudagraph_capture_size = default_max_cg_capture_size
sed -n '200,270p' /vllm-workspace/vllm-ascend/vllm_ascend/platform.py
return min(max_num_seqs * decode_query_len, 512)
由此可知:
如果使用默认的FAP,并且要支持如测试sample.jpg类似的图进行交互,max_num_seqs的设置就需要设置到很大,而max_num_seqs越大,预留的显存越多,启动时间就越慢。
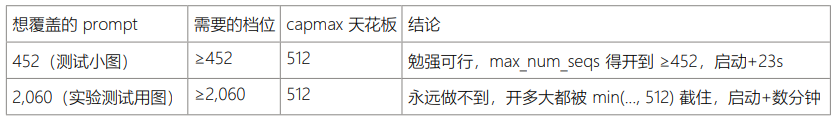
因此,通过实验环境(vllm-ascend0.23)Prefill入图优化TTFT和E2E的要点在于:
1. 定义cudegraphy mode是FAP或者使用默认定义;
2. 指定size,并且最大档位涵盖prompts长度的主要分布区间;
3. 指定size的数量通常不要超过20个;
4. mnbt必须要超过最大档位。
本文由 奶莉小跟班 原创,首发于华为昇腾社区,哦对了,我就是奶莉小跟班~~~~