27B 的 Coder 模型塞进 20GB 显存是什么体验?Q3 量化 + KV cache 8bit + Flash Attention 三件套下来,64K 上下文只吃 15.7GB,netsh 端口转发一配,局域网里另一台主机的 WorkBuddy 直接把它当 OpenAI API 用。
WSL2 + llama.cpp 部署 Qwen3.8-27B-Coder:RTX 3080 20GB 实战 OpenAI 兼容 API
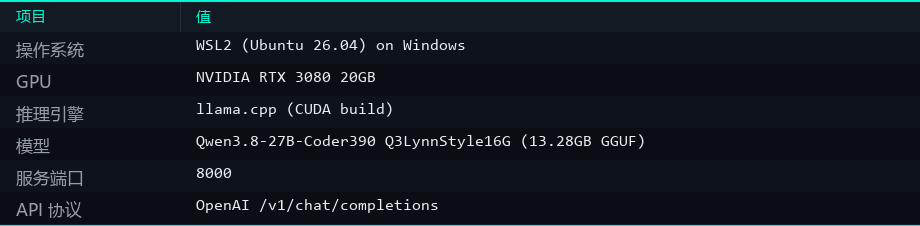
环境:Windows + WSL2 (Ubuntu 26.04) · NVIDIA RTX 3080 20GB · llama.cpp(CUDA 构建)· Qwen3.8-27B-Coder390 Q3LynnStyle16G(13.28GB GGUF)
生成日期:2026-10-26
一、环境概览与关键路径
整套方案的目标很明确:WSL2 里跑推理,对外提供 OpenAI 兼容 API,给局域网内另一台主机上的 WorkBuddy 当模型后端。先看总的环境:
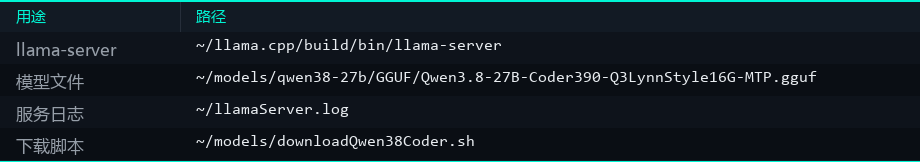
涉及的几个关键路径,后面所有命令都围绕它们展开:
二、模型下载:绕过 XetHub 认证坑
模型从 HuggingFace 镜像站(hf-mirror.com)直接下载——注意这里的坑:huggingface_hub 默认走的 XetHub CAS 后端,镜像站不支持 Xet 认证,所以直接用 wget 打镜像的 resolve 链接最稳。下载脚本如下:
#!/usr/bin/env bash
# 从 hf-mirror.com 直接下载 Qwen3.8-27B-Coder390 的 Q3LynnStyle GGUF 文件
# 绕过 huggingface_hub 的 XetHub CAS 后端(镜像不支持 Xet 认证)
set -uo pipefail

REPO="nerkyor/Qwen3.8-27B-Coder390-EfficientThink-Opus5.5-GPT6Astra-Grok4.7-DSV4Pro-K3-SFT-RLOO-MTP-DFlash2"
BASE="https://hf-mirror.com/${REPO}/resolve/main/GGUF"
DIR=/home/antares/models/qwen38-27b/GGUF
mkdir -p "$DIR"

files=(
  "Qwen3.8-27B-Coder390-EfficientThink-Q3LynnStyle-MTP.gguf"
  "Qwen3.8-27B-Coder390-EfficientThink-Q3LynnStyle-Q8MTP.gguf"
  "Qwen3.8-27B-Coder390-Q3LynnStyle16G-MTP.gguf"
)

for f in "${files[@]}"; do
    echo "[$(date +%H:%M:%S)] === 下载 $f ==="
    if wget -c --progress=dot:giga -O "$DIR/$f" "$BASE/$f"; then
        echo "[$(date +%H:%M:%S)] OK  $f"
    else
        echo "[$(date +%H:%M:%S)] FAIL $f (exit $?)"
    fi
done
echo "[$(date +%H:%M:%S)] 全部任务结束,结果:"
执行就是一行:
bash ~/models/downloadQwen38Coder.sh注:脚本里用的是 wget -c,断点续传自动生效——13GB 级别的文件下载中断了直接重跑即可,已下载的部分不会浪费。
三、启动服务
3.1 一键启动命令
nohup ~/llama.cpp/build/bin/llama-server \
  -m ~/models/qwen38-27b/GGUF/Qwen3.8-27B-Coder390-Q3LynnStyle16G-MTP.gguf \
  -ngl 99 \
  -c 65536 \
  --parallel 1 \
  --flash-attn on \
  --cache-type-k q8_0 \
  --cache-type-v q8_0 \
  --host 0.0.0.0 \
  --port 8000 \
  --alias qwen3.8-27b-coder \
  > ~/llamaServer.log 2>&1 &
3.2 参数逐条解读
这套参数组合是 20GB 显存跑 27B Q3 的核心,逐条说清楚:
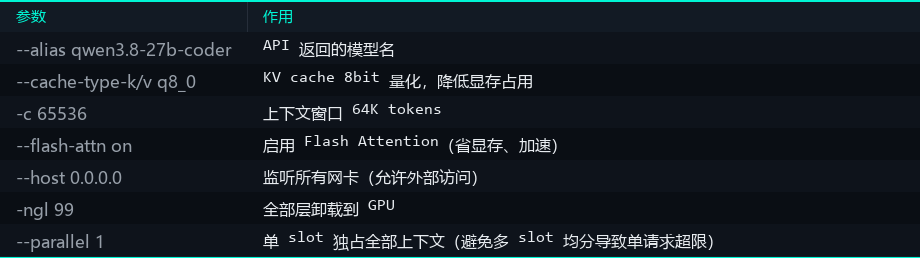
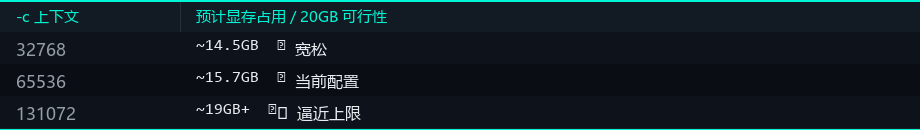
其中 --cache-type-k/v q8_0 和 --flash-attn on 是显存优化的关键二件套:KV cache 8bit 量化直接把 KV 显存砍半,Flash Attention 再省一层——两者叠加后 64K 上下文总占用控制在 15.7GB。而 --parallel 1 是个容易忽略的点:多 slot 会均分上下文窗口,单请求可用 token 直接腰斩,独占模式才能吃满 64K。
3.3 启动后验证四连
# 检查进程
pgrep -af llama-server

# 检查 API
curl -s http://localhost:8000/v1/models | python3 -m json.tool

# 推理测试
curl -s http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model":"qwen3.8-27b-coder","messages":[{"role":"user","content":"你好"}],"max_tokens":50}'

# 检查显存
nvidia-smi --query-gpu=memory.used,memory.free --format=csv,noheader
正常运行时显存占用约 15.7GB / 20GB,留有余量。
四、网络配置:WSL2 端口转发
WSL2 默认不对外暴露端口,LAN 里其他机器是连不进来的,需要在 Windows 宿主机上做一层端口转发。
4.1 查询 WSL2 IP
# 在 WSL2 内执行
hostname -I | awk '{print $1}'
# 示例输出:172.27.7.50
4.2 配置端口转发与防火墙
# PowerShell 管理员运行
netsh interface portproxy add v4tov4 listenport=8000 listenaddress=0.0.0.0 connectport=8000 connectaddress=172.27.7.50
netsh advfirewall firewall add rule name="llama-server" dir=in action=allow protocol=TCP localport=8000
4.3 查询 Windows 宿主机局域网 IP
# PowerShell 运行
Get-NetIPAddress -AddressFamily IPv4 |
  Where-Object {$_.InterfaceAlias -notlike "*WSL*" -and $_.IPAddress -notlike "127.*" -and $_.IPAddress -notlike "169.254.*" -and $_.IPAddress -notlike "172.*"} |
  Select-Object IPAddress, InterfaceAlias
# 示例输出:10.10.10.216
注:WSL2 每次重启后 IP 可能变化,connectaddress 就会失效。图省事可以写个开机脚本自动查询并更新转发规则,一劳永逸。
4.4 更新端口转发(WSL2 IP 变化时)
# 先删除旧规则再添加
netsh interface portproxy delete v4tov4 listenport=8000 listenaddress=0.0.0.0
netsh interface portproxy add v4tov4 listenport=8000 listenaddress=0.0.0.0 connectport=8000 connectaddress=<新的WSL2_IP>
五、WorkBuddy 客户端接入
在局域网另一台主机的 WorkBuddy 里按下面的参数配置 OpenAI API 连接:
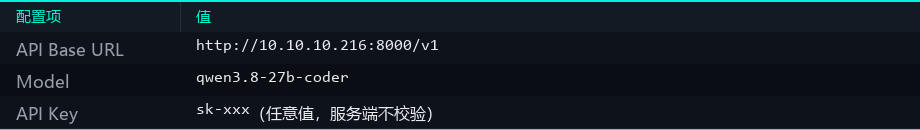
注:把 10.10.10.216 换成你自己的 Windows 宿主机实际局域网 IP;API Key 随便填,llama-server 默认不校验。
六、日常运维
6.1 停止 / 重启服务
# 停止
pkill -f "llama-server"

# 重启:杀掉后 sleep 3 再拉起
pkill -f "llama-server"; sleep 3
nohup ~/llama.cpp/build/bin/llama-server \
  -m ~/models/qwen38-27b/GGUF/Qwen3.8-27B-Coder390-Q3LynnStyle16G-MTP.gguf \
  -ngl 99 -c 65536 --parallel 1 --flash-attn on \
  --cache-type-k q8_0 --cache-type-v q8_0 \
  --host 0.0.0.0 --port 8000 --alias qwen3.8-27b-coder \
  > ~/llamaServer.log 2>&1 &
实际操作中把重启命令存成一键脚本最省心。
6.2 日志与状态
# 实时日志
tail -f ~/llamaServer.log

# 进程
pgrep -af llama-server

# 显存
nvidia-smi --query-gpu=memory.used,memory.free --format=csv,noheader

# API 可用性
curl -s http://localhost:8000/v1/models | head -5
七、故障排查手册
7.1 request exceeds the available context size
原因:请求 token 数超过上下文窗口。解决:增大 -c 并确保 --parallel 1。当前 64K 已够用,再往上加要盯着显存:
7.2 端口被占用 / 重启失败
原因:旧进程未完全释放端口。解决:强杀后确认端口空闲再拉起:
pkill -9 -f "llama-server"
sleep 5
# 确认端口空闲后再启动
ss -tlnp | grep :8000
7.3 另一台主机无法连接
按下面五步逐层排查,从内到外:
- ✓ WSL2 内服务正常:
curl http://localhost:8000/v1/models - ✓ Windows 端口转发存在:
netsh interface portproxy show v4tov4 - ✓ WSL2 IP 未变化:
hostname -I与connectaddress比对 - ✓ Windows 防火墙规则存在:
netsh advfirewall firewall show rule name="llama-server" - ✓ Windows 局域网 IP 正确:从另一台主机
ping 10.10.10.216
7.4 显存 OOM
解决:降低上下文 -c,或换更小的量化。~/models/qwen38-27b/GGUF/ 下的三个量化文件按显存量力而行:
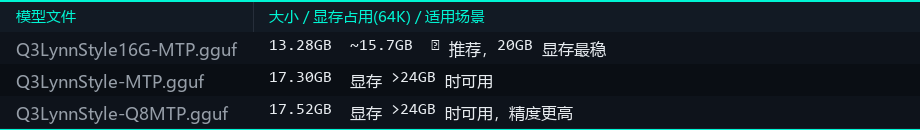
注:20GB 显存无脑选 Q3LynnStyle16G(13.28GB),是实测最稳的一档;Q8 精度更高但 17.52GB 装不下 64K 上下文,除非你显存 24GB 往上。